Job Match Pipeline
As ofertas de emprego estão espalhadas por várias fontes, a mesma oferta aparece muitas vezes repetida e avaliar se cada uma se adequa leva tempo. Este pipeline recolhe as ofertas todos os dias, junta-as numa lista única e limpa, e ordena-as face ao meu CV, para que as melhores correspondências apareçam primeiro, com uma análise escrita de pontos fortes e lacunas.
Como funciona
- 1Recolha
Uma tarefa agendada recolhe diariamente novas ofertas de várias APIs de emprego.
- 2Normalizar e deduplicar
Cada fonte é convertida num único modelo de dados e os duplicados entre fontes são removidos.
- 3Filtrar e pontuar
Filtros obrigatórios eliminam o que não encaixa e subpontuações ponderadas ordenam o resto.
- 4Correspondência semântica
Embeddings de texto (Voyage AI) medem a semelhança entre o CV e a oferta, como uma das subpontuações.
- 5Análise por LLM
Um LLM, via OpenRouter, escreve uma análise de adequação e lacunas para as melhores correspondências.
- 6Dashboard
Um dashboard em Nuxt 4 mostra as ofertas ordenadas, com filtros, acompanhamento de candidaturas, upload de CV e gráficos de estatísticas.
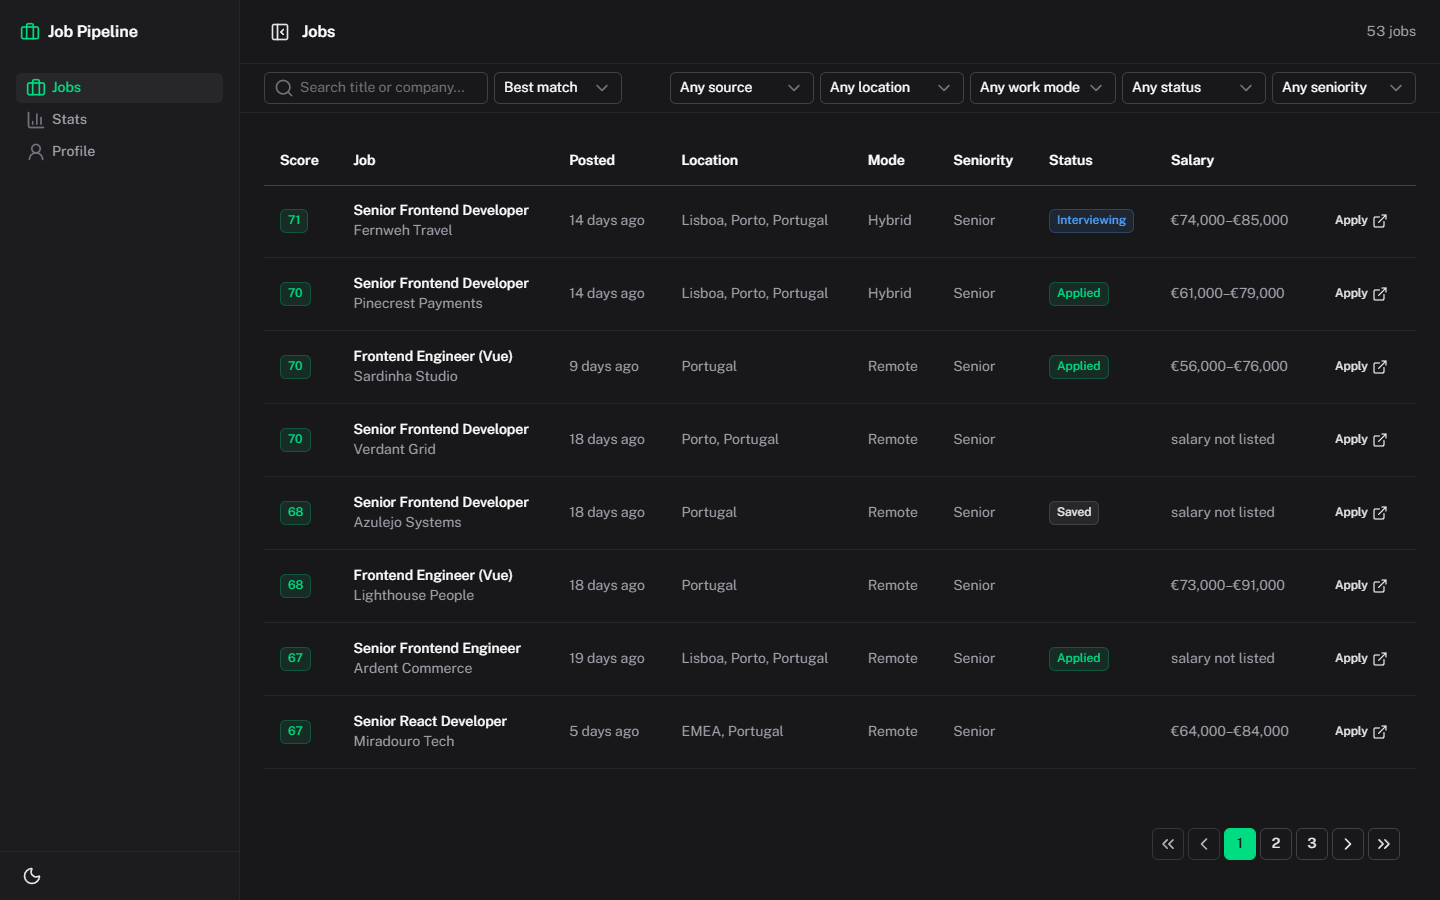
- Tabela de ofertas ordenadas, com filtros por fonte, localização, modalidade de trabalho, estado da candidatura e senioridade
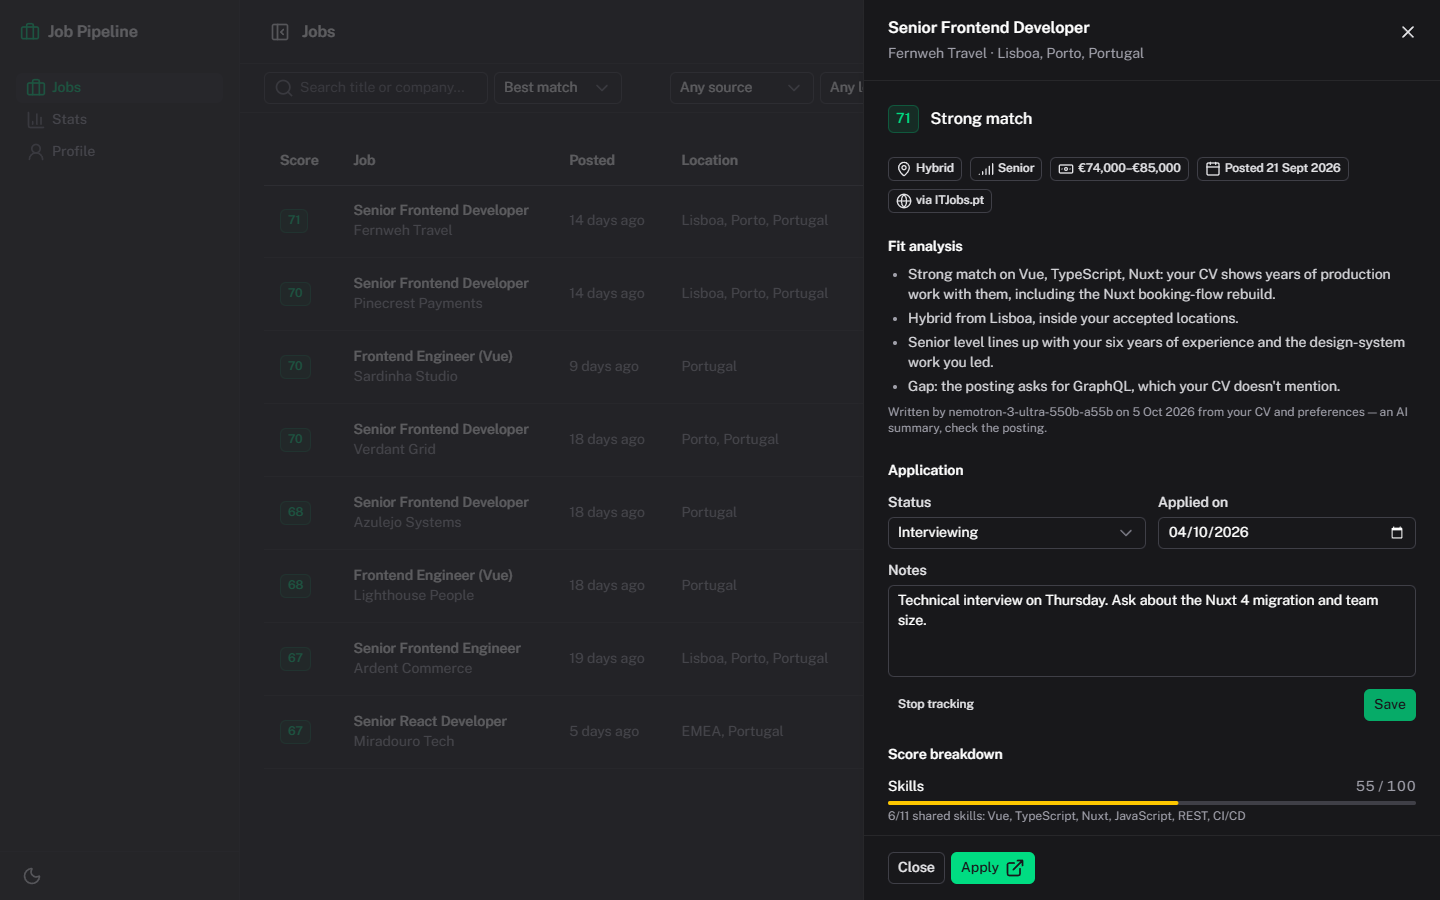
- Painel de detalhe com a análise de adequação, o estado, a data e as notas da candidatura, e a pontuação detalhada por categoria
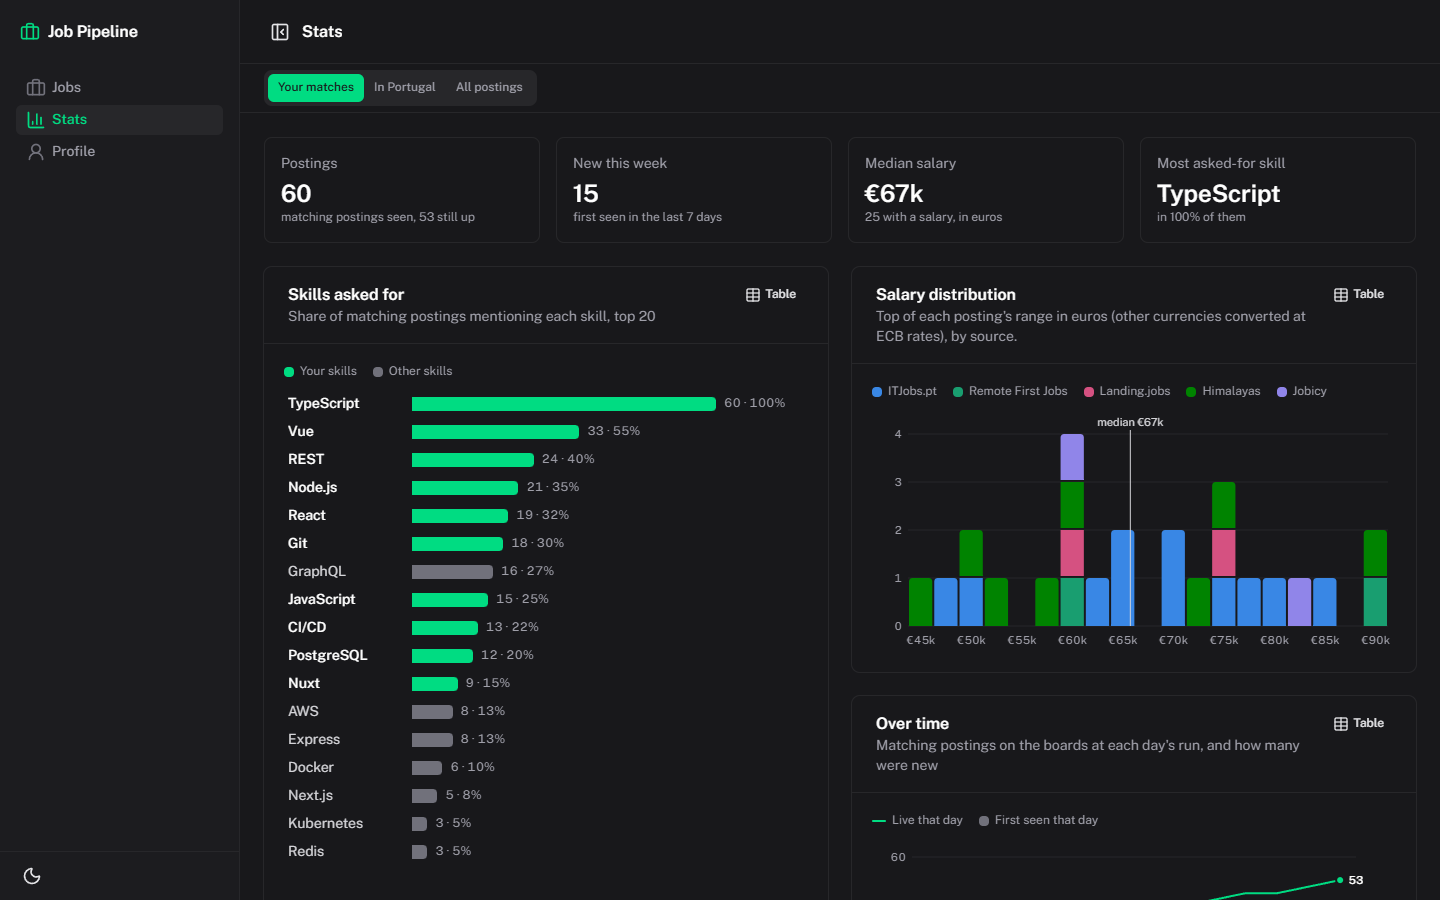
- Estatísticas das competências pedidas nas ofertas (as minhas vs. outras), distribuição salarial por fonte com conversão de moeda às taxas do BCE, e ofertas ao longo do tempo
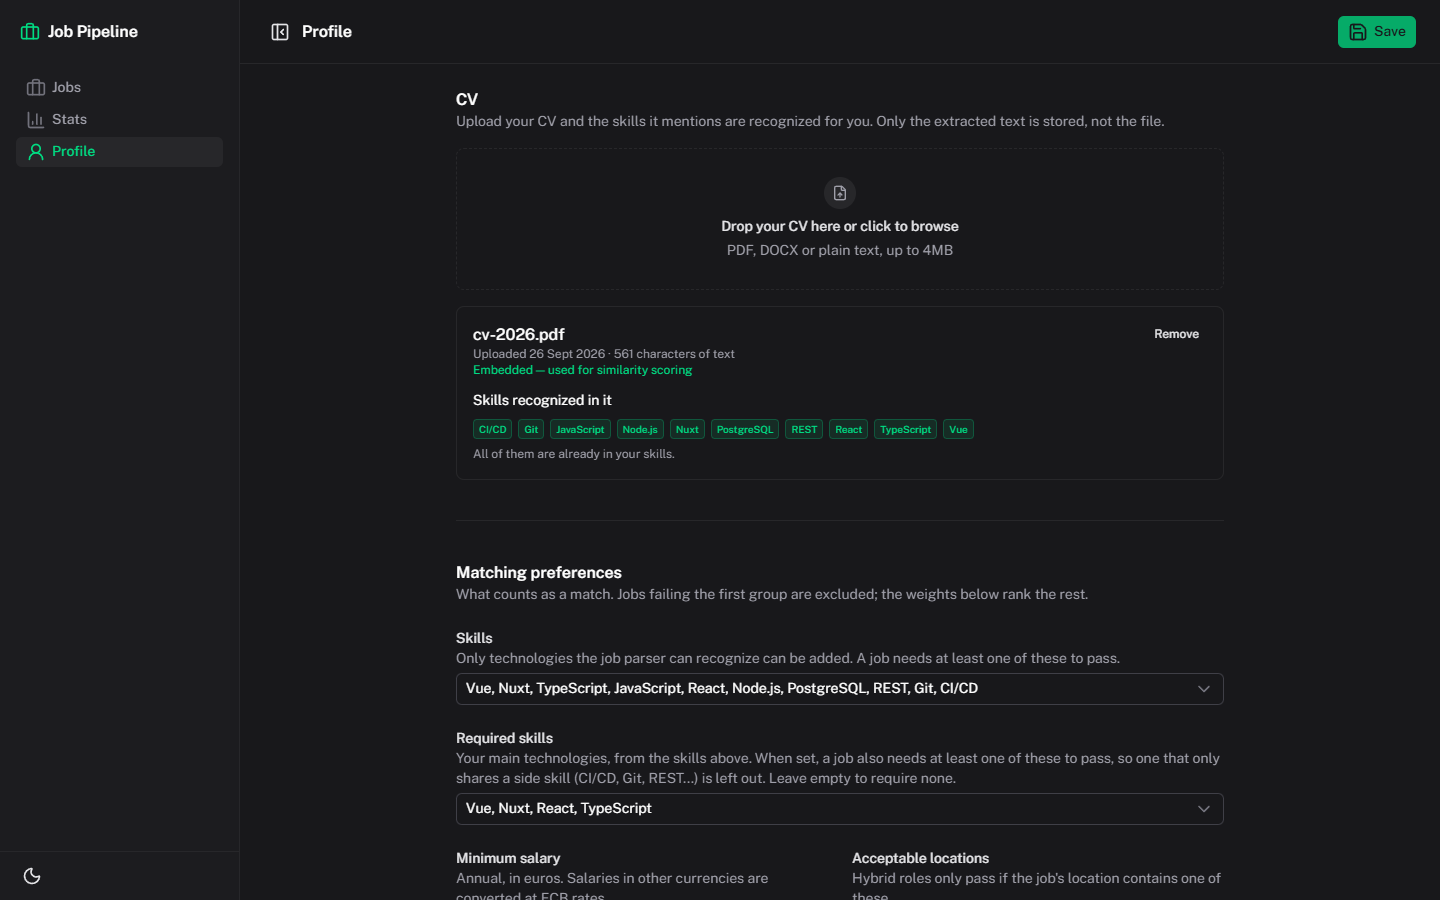
- Upload de CV que reconhece competências e guarda apenas o texto extraído, além de preferências como competências obrigatórias, salário mínimo e localizações aceites
- PostgreSQL no Neon (Postgres serverless), acedido através do Prisma ORM
- Tarefa agendada do pipeline a correr no Railway
- Dashboard alojado na Vercel
- Testes unitários com Vitest para os parsers, a pontuação e a deduplicação
- Testes end-to-end no browser com Playwright para o dashboard
- Ambos correm em CI com GitHub Actions